WhatsApp

80% OFF en todos los cursos Asíncronos Hasta el 16 de Febrero

Días
Horas
Minutos
Segundos

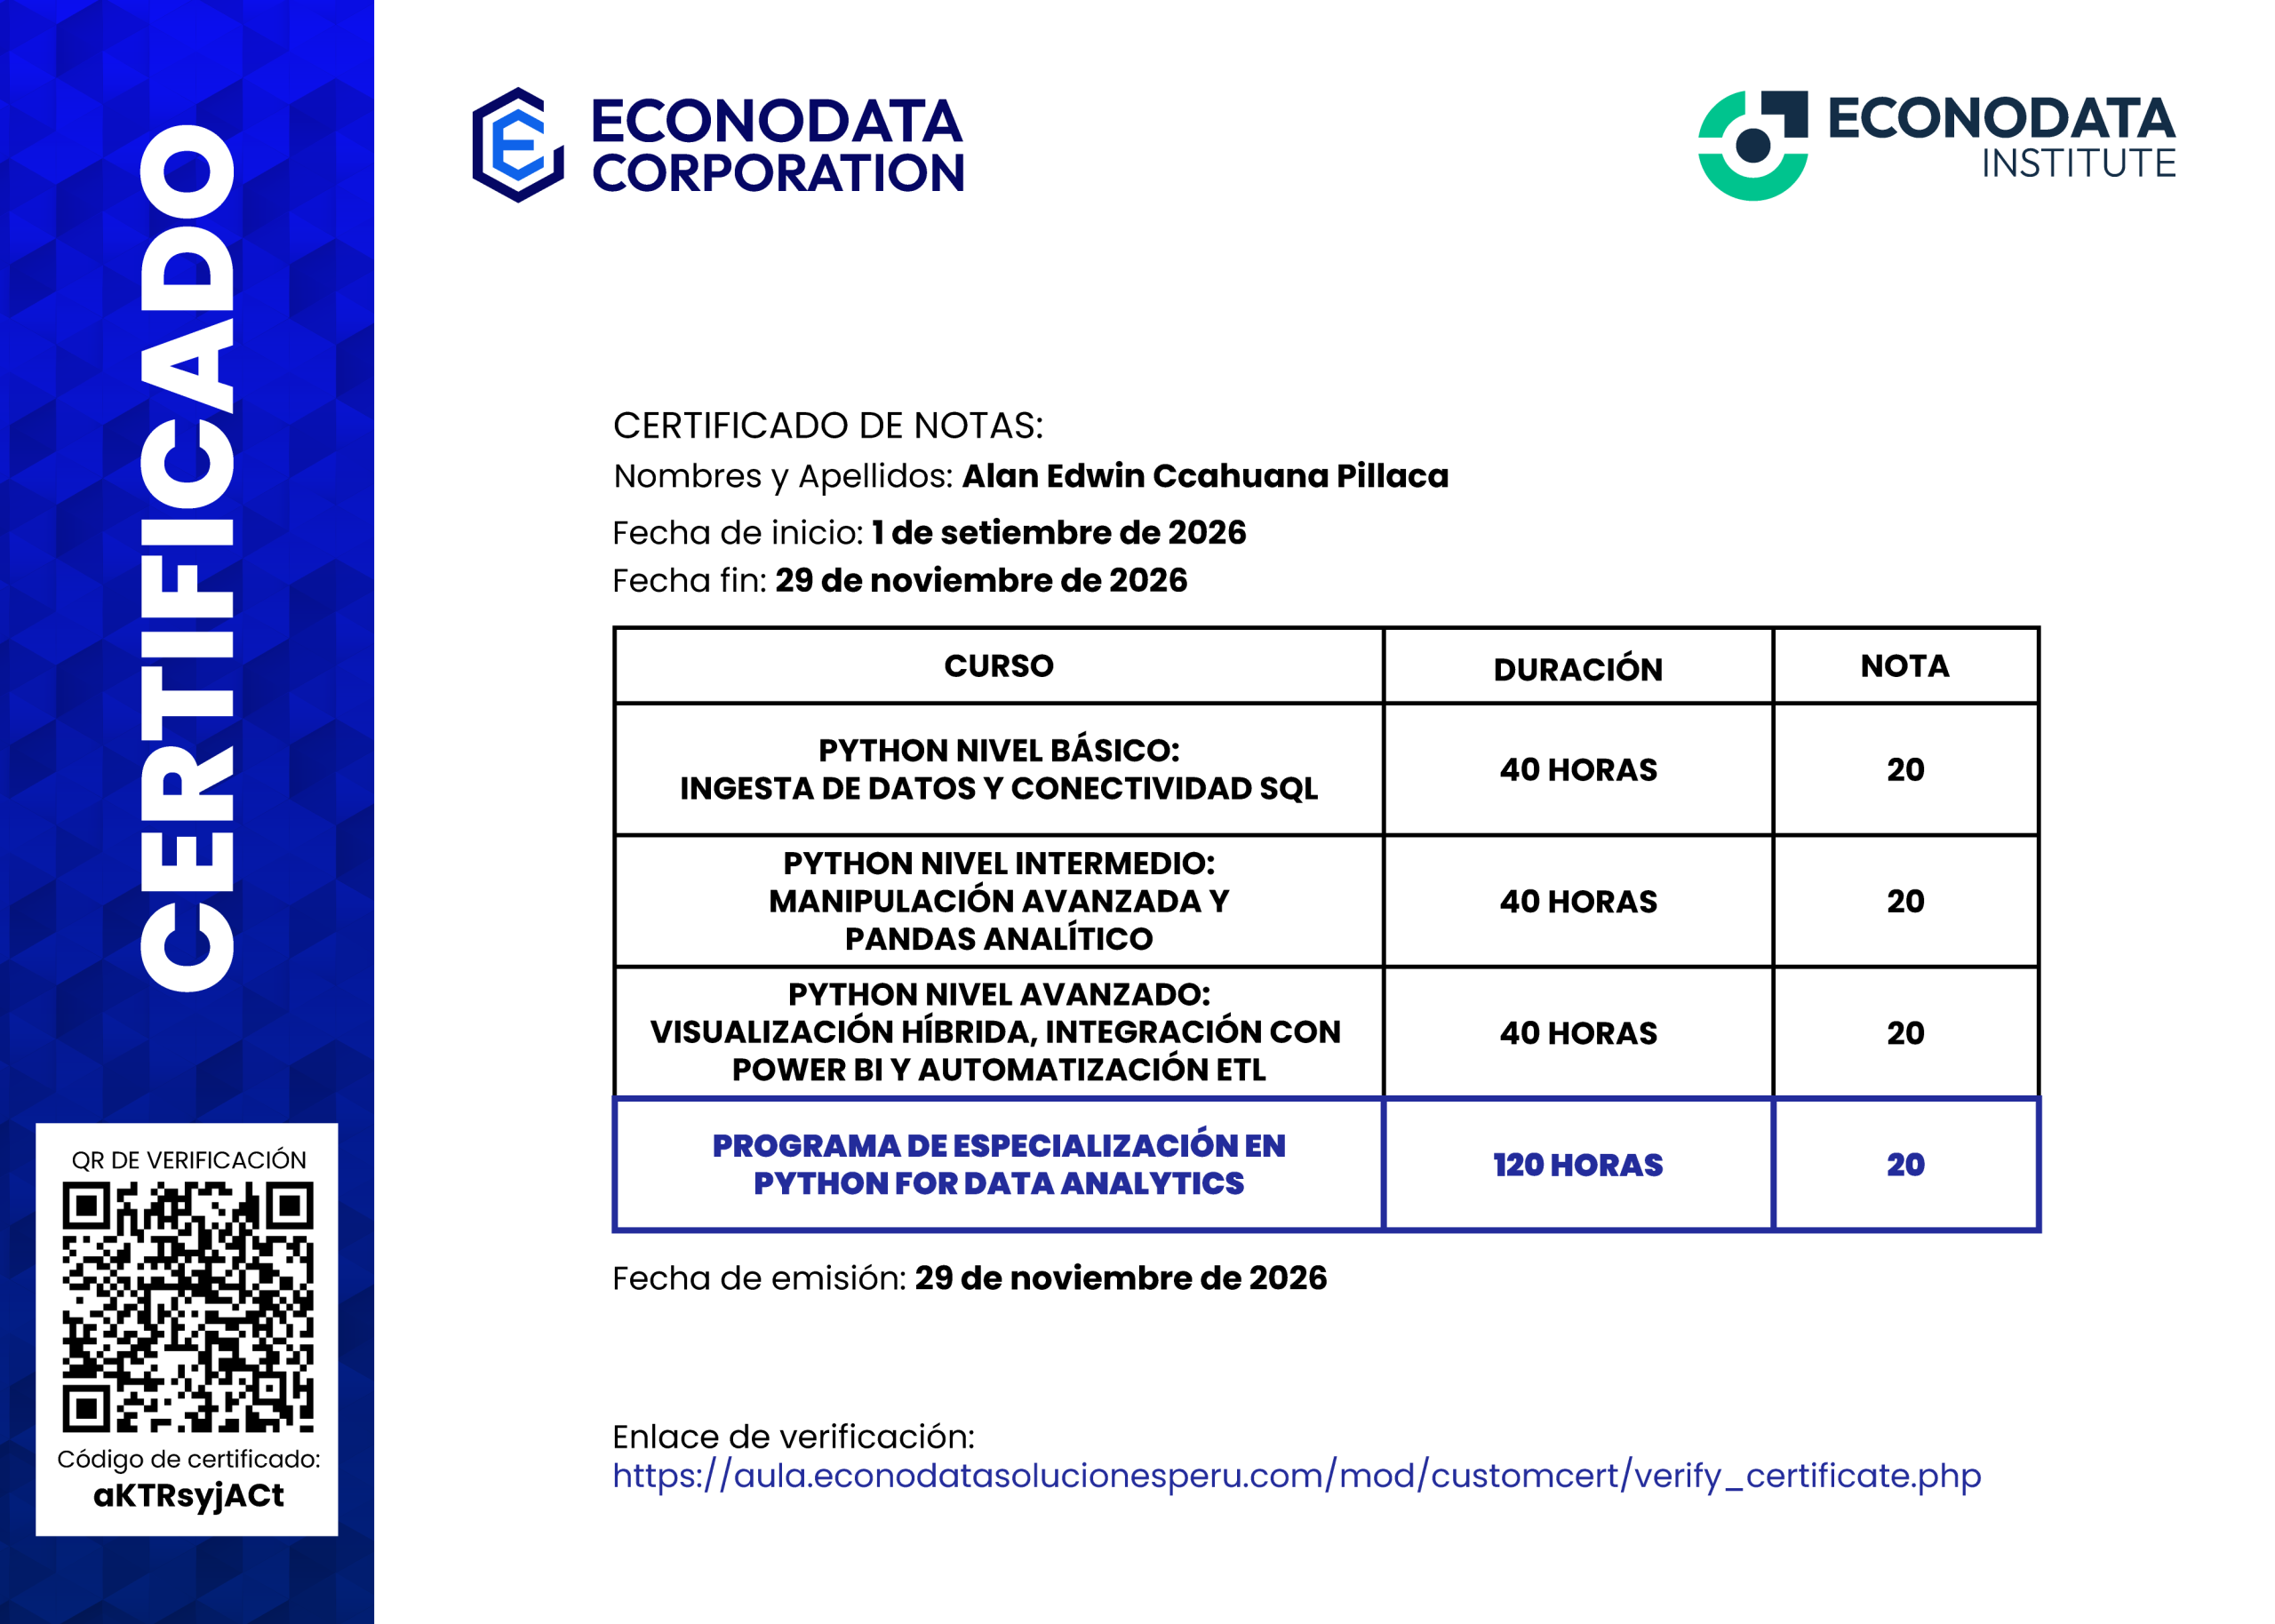
PROGRAMA DE ESPECIALIZACIÓN EN PYTHON FOR DATA ANALYTICS

Modalidad

Certificación

120 Horas Pedagógicas

54 Horas Cronológicas

¿A quien va dirigido?

Analistas y Consultores de Datos: Automatización de flujos de trabajo, limpieza avanzada con Pandas y construcción de scripts ETL.

Ingenieros y Profesionales STEM: Optimización de procesos, modelado de datos y procesamiento de grandes volúmenes de información.

Profesionales de Administración y Negocios: Transformación de reportes manuales en dashboards automatizados para la toma de decisiones.

Programadores y Desarrolladores: Especialización en análisis masivo de datos, estructuras modulares y programación orientada a objetos.

Gerentes, Líderes y Jefaturas: Supervisión técnica de proyectos de datos, eficiencia operativa e integración de soluciones tecnológicas.

Profesionales del Sector Público y Privado: Modernización de procesos analíticos, gestión eficiente de recursos y auditoría de datos corporativos.

Requisitos técnicos

Beneficios

MATERIAL ESPECIALIZADO: Documentos, videos yejercicios prácticos.

FLEXIBILIDAD: Todas las clases en vivo se resuben a nuestra aula virtual, para que puedas estudiar a tu propio ritmo.

ASESORÍA DIGITAL: Programación y análisis de datos en Python con acompañamiento digital especializado, resolviendo dudas en tiempo real y optimizando tu código con guía.

CERTIFICACIÓN INMEDIATA: Certificado digital con reconocimiento de la CÁMARA DE COMERCIO DE LIMA-Asociado(CCL), Econodata Institute y Econodata Corporation.
🟢MÓDULO I: ENTORNO ANALÍTICO Y CONECTIVIDAD CON SQL SERVER 2025 (3 horas)

  1. 20% Teoría: Arquitectura de un flujo de análisis de datos corporativo. Configuración del entorno de trabajo con Jupyter Notebook y VS Code. Introducción a las librerías pyodbc y SQLAlchemy, cadenas de conexión y principios de conectividad entre Python y SQL Server 2025.
  2. 80% Práctica: Configuración del entorno y conexión de Python con SQL Server. Extracción de información desde tablas transaccionales de un caso empresarial de Retail/E-commerce, utilizando tablas de clientes, productos, ventas y detalle de ventas. Exploración inicial de los datos extraídos y generación de un primer dataset analítico.
  3. Recurso práctico: Base de datos SQL Server Retail Analytics, con tablas clientes, productos, ventas, detalle_ventas y tiendas.
  4. Producto de la sesión: Notebook de conexión y extracción de datos desde SQL Server.

🟢MÓDULO II: TIPOS DE DATOS Y ESTRUCTURAS DE CONTROL PARA AUDITORÍA (3 horas)

  1. 20% Teoría: Tipos de datos fundamentales de Python (int, float, str, bool) y estructuras nativas como listas y tuplas. Estructuras condicionales if, elif y else aplicadas a reglas de validación y control de calidad de datos.
  2. 80% Práctica: Desarrollo de un laboratorio de auditoría de datos utilizando información de clientes. Validación de campos como DNI, edad, correo electrónico, teléfono y datos obligatorios. Clasificación automática de registros como válidos, inválidos o pendientes de revisión.
  3. Recurso práctico: Dataset clientes_auditoria.csv, que contiene valores nulos, formatos incorrectos, edades inválidas, correos electrónicos incompletos y teléfonos inconsistentes.
  4. Producto de la sesión: Script de auditoría automática de calidad de datos.

🟢MÓDULO III: DICCIONARIOS Y MAPEO DE REGLAS DE NEGOCIO (3 horas)

  1. 20% Teoría: Estructura y funcionamiento de diccionarios. Relaciones llave-valor y aplicación de estructuras de mapeo para la estandarización de catálogos y dimensiones empresariales.
  2. 80% Práctica: Construcción de diccionarios de conversión para normalizar categorías, ciudades, tipos de clientes y otros atributos provenientes de diferentes fuentes. Implementación de reglas de negocio para homologar valores heterogéneos.
  3. Recurso práctico: Dataset catalogo_productos.csv con categorías inconsistentes como TEC, Tecnologia, TECNOLOGIA, Tecnología, entre otras.
  4. Producto de la sesión: Diccionario de homologación y script de normalización de
    catálogos.
  5. 📝 HITO DE EVALUACIÓN (Asíncrono): Al finalizar esta sesión se libera el Examen Parcial I: Fundamentos e Ingesta de Datos. El participante deberá conectarse a una fuente de datos, realizar validaciones de calidad mediante estructuras de control y aplicar reglas de normalización utilizando colecciones y diccionarios.

🟢MÓDULO IV: AUTOMATIZACIÓN DE LECTURA MASIVA CON BUCLES (3 horas)

  1. 20% Teoría: Iteraciones con for y while, recorrido de estructuras de datos, funciones range() y enumerate(). Introducción a List Comprehensions y criterios básicos para escribir código eficiente y reutilizable.
  2. 80% Práctica: Desarrollo de un proceso automatizado para leer y consolidar múltiples archivos históricos de ventas. El participante deberá recorrer una carpeta con archivos mensuales, identificar los archivos disponibles, procesarlos y generar un único dataset consolidado.
  3. Recurso práctico: Conjunto de archivos ventas_enero.csv hasta ventas_diciembre.csv.
  4. Producto de la sesión: Script de consolidación automática de archivos históricos de ventas.

🟢MÓDULO V: MODULARIZACIÓN: CREACIÓN DE FUNCIONES DE LIMPIEZA REUTILIZABLES (3 horas)

  1. 20% Teoría: Definición de funciones mediante def, parámetros, valores de retorno y expresiones lambda. Principios de modularización, reutilización y organización del código aplicado al análisis de datos.
  2. 80% Práctica: Desarrollo de una biblioteca propia denominada limpieza_corporativa.py, incorporando funciones para limpiar textos, normalizar categorías, validar correos, transformar fechas, limpiar teléfonos y estandarizar valores numéricos.
  3. Recurso práctico: Dataset empresarial de clientes y productos con errores de formato y contenido.
  4. Producto de la sesión: Biblioteca reutilizable de funciones de limpieza y notebook de pruebas.

🟢MÓDULO VI: PROGRAMACIÓN ORIENTADA A OBJETOS APLICADA A CONECTORES (3 horas)

  1. 20% Teoría: Conceptos fundamentales de Programación Orientada a Objetos: clases, objetos, atributos, métodos, constructor y encapsulamiento. Aplicación de POO al desarrollo de componentes reutilizables para análisis de datos.
  2. 80% Práctica: Diseño, implementación y prueba de una clase personalizada SQLConnector para establecer conexiones, ejecutar consultas, extraer tablas y gestionar de forma estructurada las conexiones con SQL Server.
  3. Recurso práctico: Base de datos Retail Analytics utilizada durante el Nivel I.
  4. Producto de la sesión: Módulo Python de conexión reutilizable y documentación básica de uso.
  5. 📝 HITO DE EVALUACIÓN (Asíncrono): Al finalizar esta sesión se libera el Examen Final I: Desarrollo de Módulos de Ingesta. El participante deberá entregar un script estructurado y modularizado que permita realizar la extracción automatizada desde SQL Server utilizando funciones y Programación Orientada a Objetos.

🟢MÓDULO VII: INTRODUCCIÓN A SERIES Y DATAFRAMES CON PANDAS (3 horas)

  1. 20% Teoría: Arquitectura de Pandas, Series y DataFrames. Tipos de datos (dtypes), indexación y selección de información mediante loc e iloc. Exploración y diagnóstico inicial de datasets.
  2. 80% Práctica: Ingesta y exploración de un dataset transaccional de gran volumen. Análisis de estructura, dimensiones, tipos de datos, estadísticas descriptivas y optimización básica del consumo de memoria.
  3. Recurso práctico: Dataset ventas_2023_2026.csv, con cientos de miles o millones de registros transaccionales.
  4. Producto de la sesión: Notebook de Exploratory Data Analysis (EDA) inicial y diagnóstico del dataset.

🟢MÓDULO VIII: TRATAMIENTO DE DATOS PERDIDOS, DUPLICADOS E INCONSISTENCIAS (3 horas)

  1. 20% Teoría: Diagnóstico de calidad de datos mediante valores nulos, duplicados e inconsistencias. Estrategias de eliminación, reemplazo e imputación de valores faltantes. Criterios para decidir cuándo conservar, corregir o eliminar información.
  2. 80% Práctica: Construcción de un pipeline de limpieza sobre un dataset empresarial deliberadamente corrupto. Identificación y tratamiento de valores NaN, registros duplicados, formatos inconsistentes, categorías incorrectas y valores inválidos.
  3. Recurso práctico: Dataset ventas_raw_corrupto.csv.
  4. Producto de la sesión: Dataset limpio y pipeline reproducible de Data Quality.

🟢MÓDULO IX: MANIPULACIÓN DE STRINGS Y ANÁLISIS DE SERIES TEMPORALES (3 horas)

  1. 20% Teoría: Métodos vectorizados de texto mediante .str y tratamiento de fechas mediante datetime. Extracción de año, mes, trimestre, semana y día de la semana. Fundamentos de análisis temporal, tendencia y estacionalidad.
  2. 80% Práctica: Limpieza y transformación de campos textuales y fechas. Construcción de variables temporales y análisis de comportamiento de las ventas por períodos. Cálculo de KPIs como ventas mensuales, ticket promedio y crecimiento temporal.
  3. Recurso práctico: Dataset de ventas históricas 2023–2026.
  4. Caso de estudio: ¿Cuándo vende más la empresa? Identificación de períodos de mayor demanda y comportamiento estacional.
  5. Producto de la sesión: Informe de análisis temporal y KPIs de negocio.
  6. 📝 HITO DE EVALUACIÓN (Asíncrono): Al finalizar esta sesión se libera el Examen Parcial II: Data Cleaning Avanzado. El participante deberá recibir un dataset con errores de texto, fechas y valores nulos y desarrollar un pipeline de Pandas que permita obtener un dataset validado y listo para análisis.

🟢MÓDULO X: FUSIONES, CRUCES Y COMBINACIÓN DE FUENTES (MERGES & JOINS) (3 horas)

  1. 20% Teoría: Lógica de conjuntos aplicada a DataFrames. Relaciones entre tablas y tipos
    de uniones inner, left, right y outer. Conciliación y validación de información procedente de diferentes fuentes.
  2. 80% Práctica: Integración de información de ventas proveniente de SQL Server con metas comerciales almacenadas en Excel y catálogos externos en CSV. Construcción de un dataset maestro mediante merge(), concat() y validación de relaciones.
  3. Recurso práctico: Base SQL Server + metas_vendedores.xlsx + catalogo_productos.csv.
  4. Caso de estudio: Conciliación de ventas reales versus metas comerciales.
  5. Producto de la sesión: Dataset maestro integrado y validado.

🟢MÓDULO XI: AGREGACIONES AVANZADAS Y MATRICES PIVOTADAS (3 horas)

  1. 20% Teoría: Agrupamientos mediante groupby(), agregaciones múltiples con .agg() y construcción de tablas dinámicas mediante pivot_table(). Diseño de indicadores y reportes resumen orientados a la toma de decisiones.
  2. 80% Práctica: Construcción de un cubo analítico comercial a partir del dataset maestro. Cálculo de ventas, costos, margen, margen porcentual, ticket promedio, unidades vendidas y ventas acumuladas por diferentes dimensiones.
  3. Recurso práctico: dataset_maestro.csv generado en la sesión anterior.
  4. Caso de estudio: Análisis de desempeño comercial por región, categoría, tienda y producto.
  5. Producto de la sesión: Reporte analítico multidimensional construido con Pandas.

🟢MÓDULO XII: ESTADÍSTICA ANALÍTICA PARA NEGOCIOS Y DETECCIÓN DE OUTLIERS (3 horas)

  1. 20% Teoría: Medidas de tendencia central y dispersión. Media, mediana, percentiles, cuartiles y Rango Intercuartílico (IQR). Identificación e interpretación de valores atípicos desde una perspectiva de negocio.
  2. 80% Práctica: Desarrollo de un sistema básico de detección de transacciones atípicas. Identificación de operaciones sospechosas según monto, comportamiento y distribución estadística. Clasificación de registros como normales o atípicos y generación de alertas.
  3. Recurso práctico: Dataset transacciones.csv con información de clientes, fechas, montos, ciudades, canales y tipos de pago.
  4. Caso de estudio: Detección de transacciones comerciales atípicas.
  5. Producto de la sesión: Script de detección de anomalías y dataset analítico validado.
  6. 📝 HITO DE EVALUACIÓN (Asíncrono): Al finalizar esta sesión se libera el Examen Final II: Consolidación y Modelado Analítico. El participante deberá integrar múltiples fuentes, realizar limpieza y transformación, generar variables agregadas, detectar anomalías y entregar un Dataset Maestro Analítico listo para visualización.

🟢MÓDULO XIII: VISUALIZACIÓN ANALÍTICA EN PYTHON CON MATPLOTLIB y SEABORN (3 horas)

  1. 20% Teoría: Principios de visualización y storytelling con datos. Selección del gráfico adecuado según la pregunta analítica. Personalización de gráficos estadísticos y criterios para construir visualizaciones orientadas a usuarios ejecutivos.
  2. 80% Práctica: Desarrollo de un informe visual a partir del Dataset Maestro. Construcción de gráficos de distribución, histogramas, boxplots, mapas de calor, series temporales y comparaciones de desempeño por categorías y regiones. ◦ Recurso práctico: dataset_maestro.csv desarrollado durante el Nivel II.
  3. Caso de estudio: Informe Ejecutivo de Ventas y Rentabilidad.
  4. Producto de la sesión: Reporte analítico visual desarrollado completamente en Python.

🟢MÓDULO XIV: INTEGRACIÓN AVANZADA: PYTHON COMO MOTOR DE DATOS EN POWER BI (3 horas)

  1. 20% Teoría: Arquitectura híbrida Python–Power BI. Responsabilidades de Python como motor de extracción y transformación y de Power BI como plataforma de modelado y visualización interactiva. Flujo de datos entre ambos entornos.
  2. 80% Práctica: Configuración de Power BI Desktop para utilizar un pipeline de Python/Pandas. Importación del Dataset Maestro, construcción del modelo de datos y desarrollo de un dashboard comercial con filtros, segmentadores, KPIs y visualizaciones interactivas.
  3. Recurso práctico: Dataset Maestro generado en el Nivel II.
  4. Caso de estudio: Dashboard Ejecutivo de Gestión Comercial.
  5. Producto de la sesión: Archivo .pbix con dashboard funcional integrado con Python.

🟢MÓDULO XV: OPTIMIZACIÓN CON DAX AVANZADO PARA ANALISTAS SENIOR (3 horas)

  1. 20% Teoría: Modelo de datos en estrella, tablas de hechos y dimensiones, relaciones y contexto de evaluación. Introducción a medidas DAX y funciones de inteligencia temporal como CALCULATE() y SAMEPERIODLASTYEAR().
  2. 80% Práctica: Desarrollo de medidas DAX para analizar ventas, margen, variaciones interanuales, crecimiento porcentual, acumulados y comparación con períodos anteriores. Optimización del dashboard desarrollado en la sesión anterior.
  3. Recurso práctico: Modelo Power BI del caso Retail Analytics.
  4. Caso de estudio: Análisis interanual del desempeño comercial.
  5. Producto de la sesión: Dashboard ejecutivo con medidas DAX avanzadas.
  6. 📝 HITO DE EVALUACIÓN (Asíncrono): Al finalizar esta sesión se libera el Examen Parcial III: Ecosistema Visual Híbrido. El participante deberá entregar el archivo de Power BI integrado con Python, el modelo de datos y un conjunto de medidas DAX que respondan a un escenario empresarial específico.

🟢MÓDULO XVI: AUTOMATIZACIÓN DE PIPELINES ETL ROBUSTOS (END-TO-END) (3 horas)

  1. 20% Teoría: Principios de diseño de pipelines ETL robustos y mantenibles. Manejo de
    errores y excepciones mediante try-except, validación de datos, generación de logs y organización modular de proyectos de datos.
  2. 80% Práctica: Consolidación de los desarrollos de los niveles anteriores en un pipeline ETL completo. Implementación de las etapas Extract, Validate, Transform y Load. Desarrollo de un archivo pipeline_maestro.py que permita ejecutar el proceso completo de forma controlada y generar logs de auditoría.
  3. Recurso práctico: Base SQL Server + Dataset Maestro + Dashboard Power BI.
  4. Caso de estudio: Automatización de la generación del reporte comercial.
  5. Producto de la sesión: Pipeline ETL modular pipeline_maestro.py, configuración y sistema de logs.

🟢MÓDULO XVII: ORQUESTACIÓN Y PROGRAMACIÓN DE TAREAS AUTOMÁTICAS (ZERO-TOUCH) (3 horas)

  1. 20% Teoría: Conceptos de ejecución desatendida y orquestación básica de procesos de datos. Configuración de tareas programadas mediante Windows Task Scheduler y Cron Jobs en Linux. Gestión de rutas, ejecución de scripts y registros de actividad.
  2. 80% Práctica: Configuración de un proceso automático de extracción de información desde SQL Server, ejecución del pipeline de limpieza y transformación, actualización del Dataset Maestro y generación de los archivos necesarios para el reporte. Implementación de logs para comprobar las ejecuciones.
  3. Recurso práctico: Pipeline ETL desarrollado en la sesión 16 y entorno Windows/Linux.
  4. Caso de estudio: Actualización automática del reporte comercial fuera del horario laboral.
  5. Producto de la sesión: Pipeline ejecutándose de forma programada y desatendida.

🟢MÓDULO XVIII: SUSTENTACIÓN DEL PROYECTO DE AUTOMATIZACIÓN FINAL (3 horas)

  1. 20% Teoría: Defensa técnica de arquitecturas de datos. Explicación de las decisiones de diseño, calidad y transformación de datos, arquitectura ETL, mecanismos de control de errores y criterios utilizados para automatizar el proceso. Cuantificación de la eficiencia obtenida en tiempos de procesamiento y reducción de horas-hombre asociadas a reportes manuales.
  2. 80% Práctica: Presentación ejecutiva en vivo del proyecto final. Demostración del flujo completo desde la extracción de datos hasta la transformación, generación del dataset, actualización del entorno analítico y visualización en Power BI. Ejecución del pipeline de extremo a extremo y presentación de resultados, métricas y evidencias de automatización. Feedback técnico sobre arquitectura, calidad de código, eficiencia y escalabilidad.
  3. Caso de estudio: Automatización End-to-End del proceso de análisis y reporte comercial.
  4. Producto final: Solución completa de Data Analytics automatizada.
  5. 📝 HITO DE EVALUACIÓN (Asíncrono): Al finalizar la sesión se habilita la entrega formal en la plataforma del Examen Final III: Repositorio ETL y Orquestación Desatendida, que incluye el código Python empaquetado, módulos de extracción y transformación, configuración del pipeline, logs generados durante pruebas reales, documentación técnica, evidencias de ejecución automatizada y el Dashboard de Power BI completamente integrado y automatizado.

Precio del Curso

S/249.00

*PRONTO PAGO VÁLIDO HASTA EL 28 DE MARZO*
Docente
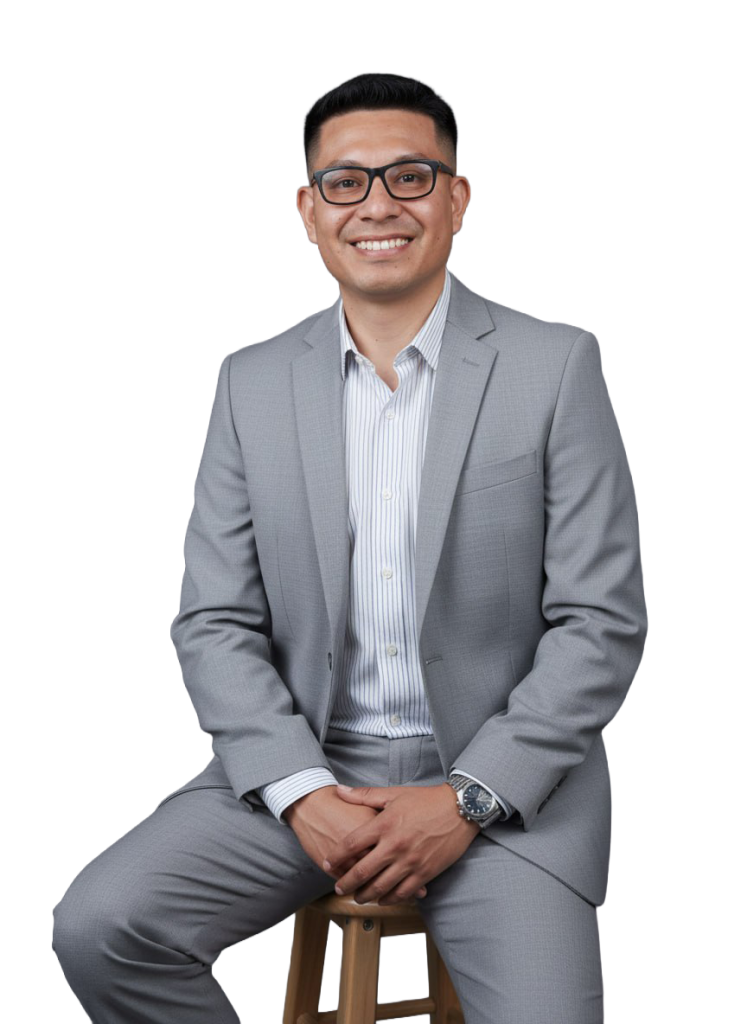
Ing. Alexander O. Valdez P.

+14 AÑOS DE EXPERIENCIA

Actual Especialista y Supervisor de Radar AMISR-14 (Instituto Geofísico del Perú). Ingeniero Electrónico y egresado de Maestría en Ciencias de la Computación (UNI). Especialista en Python, Machine Learning, IA Generativa (RAG/LangChain) y Procesamiento de Datos Científicos.
PROGRAMA DE ESPECIALIZACIÓN EN PYTHON FOR DATA ANALYTICS