WhatsApp

80% OFF en todos los cursos Asíncronos Hasta el 16 de Febrero

Días
Horas
Minutos
Segundos

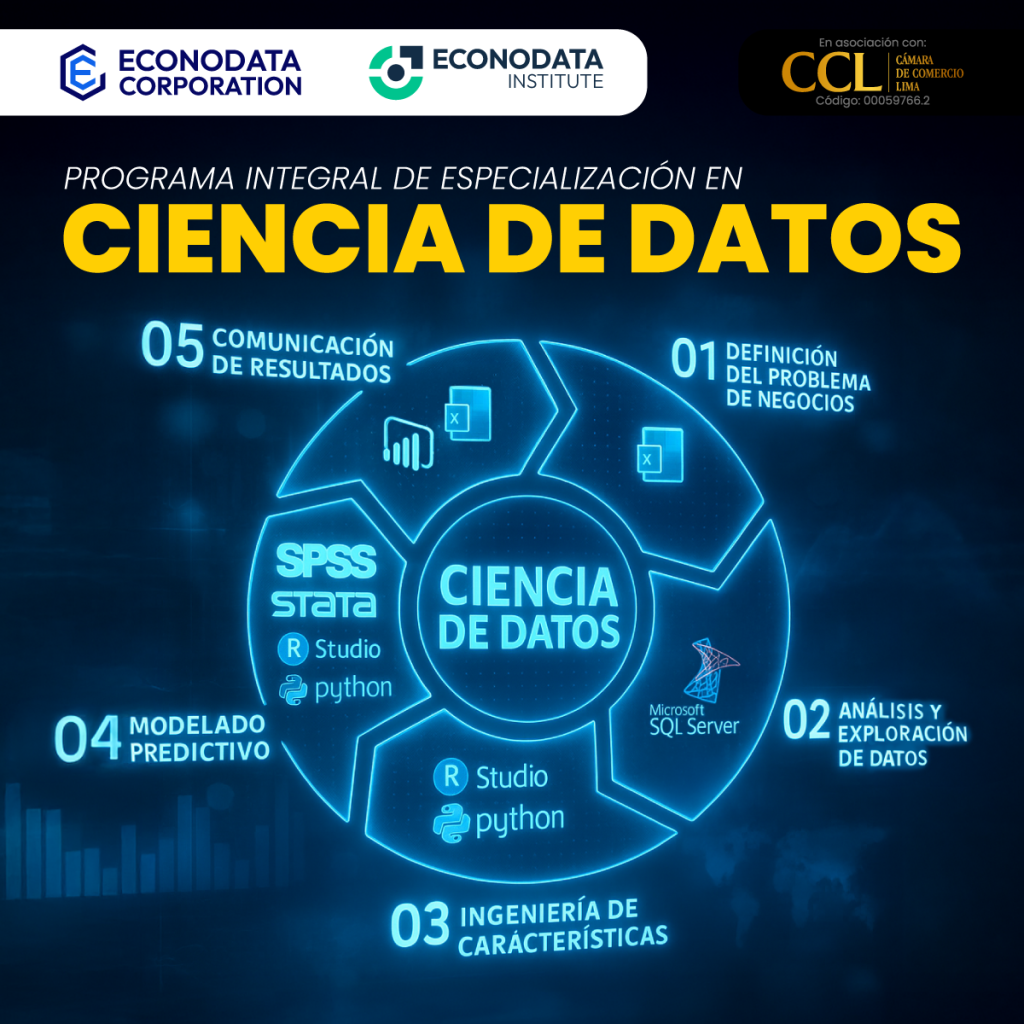
CIENCIA DE DATOS

Modalidad

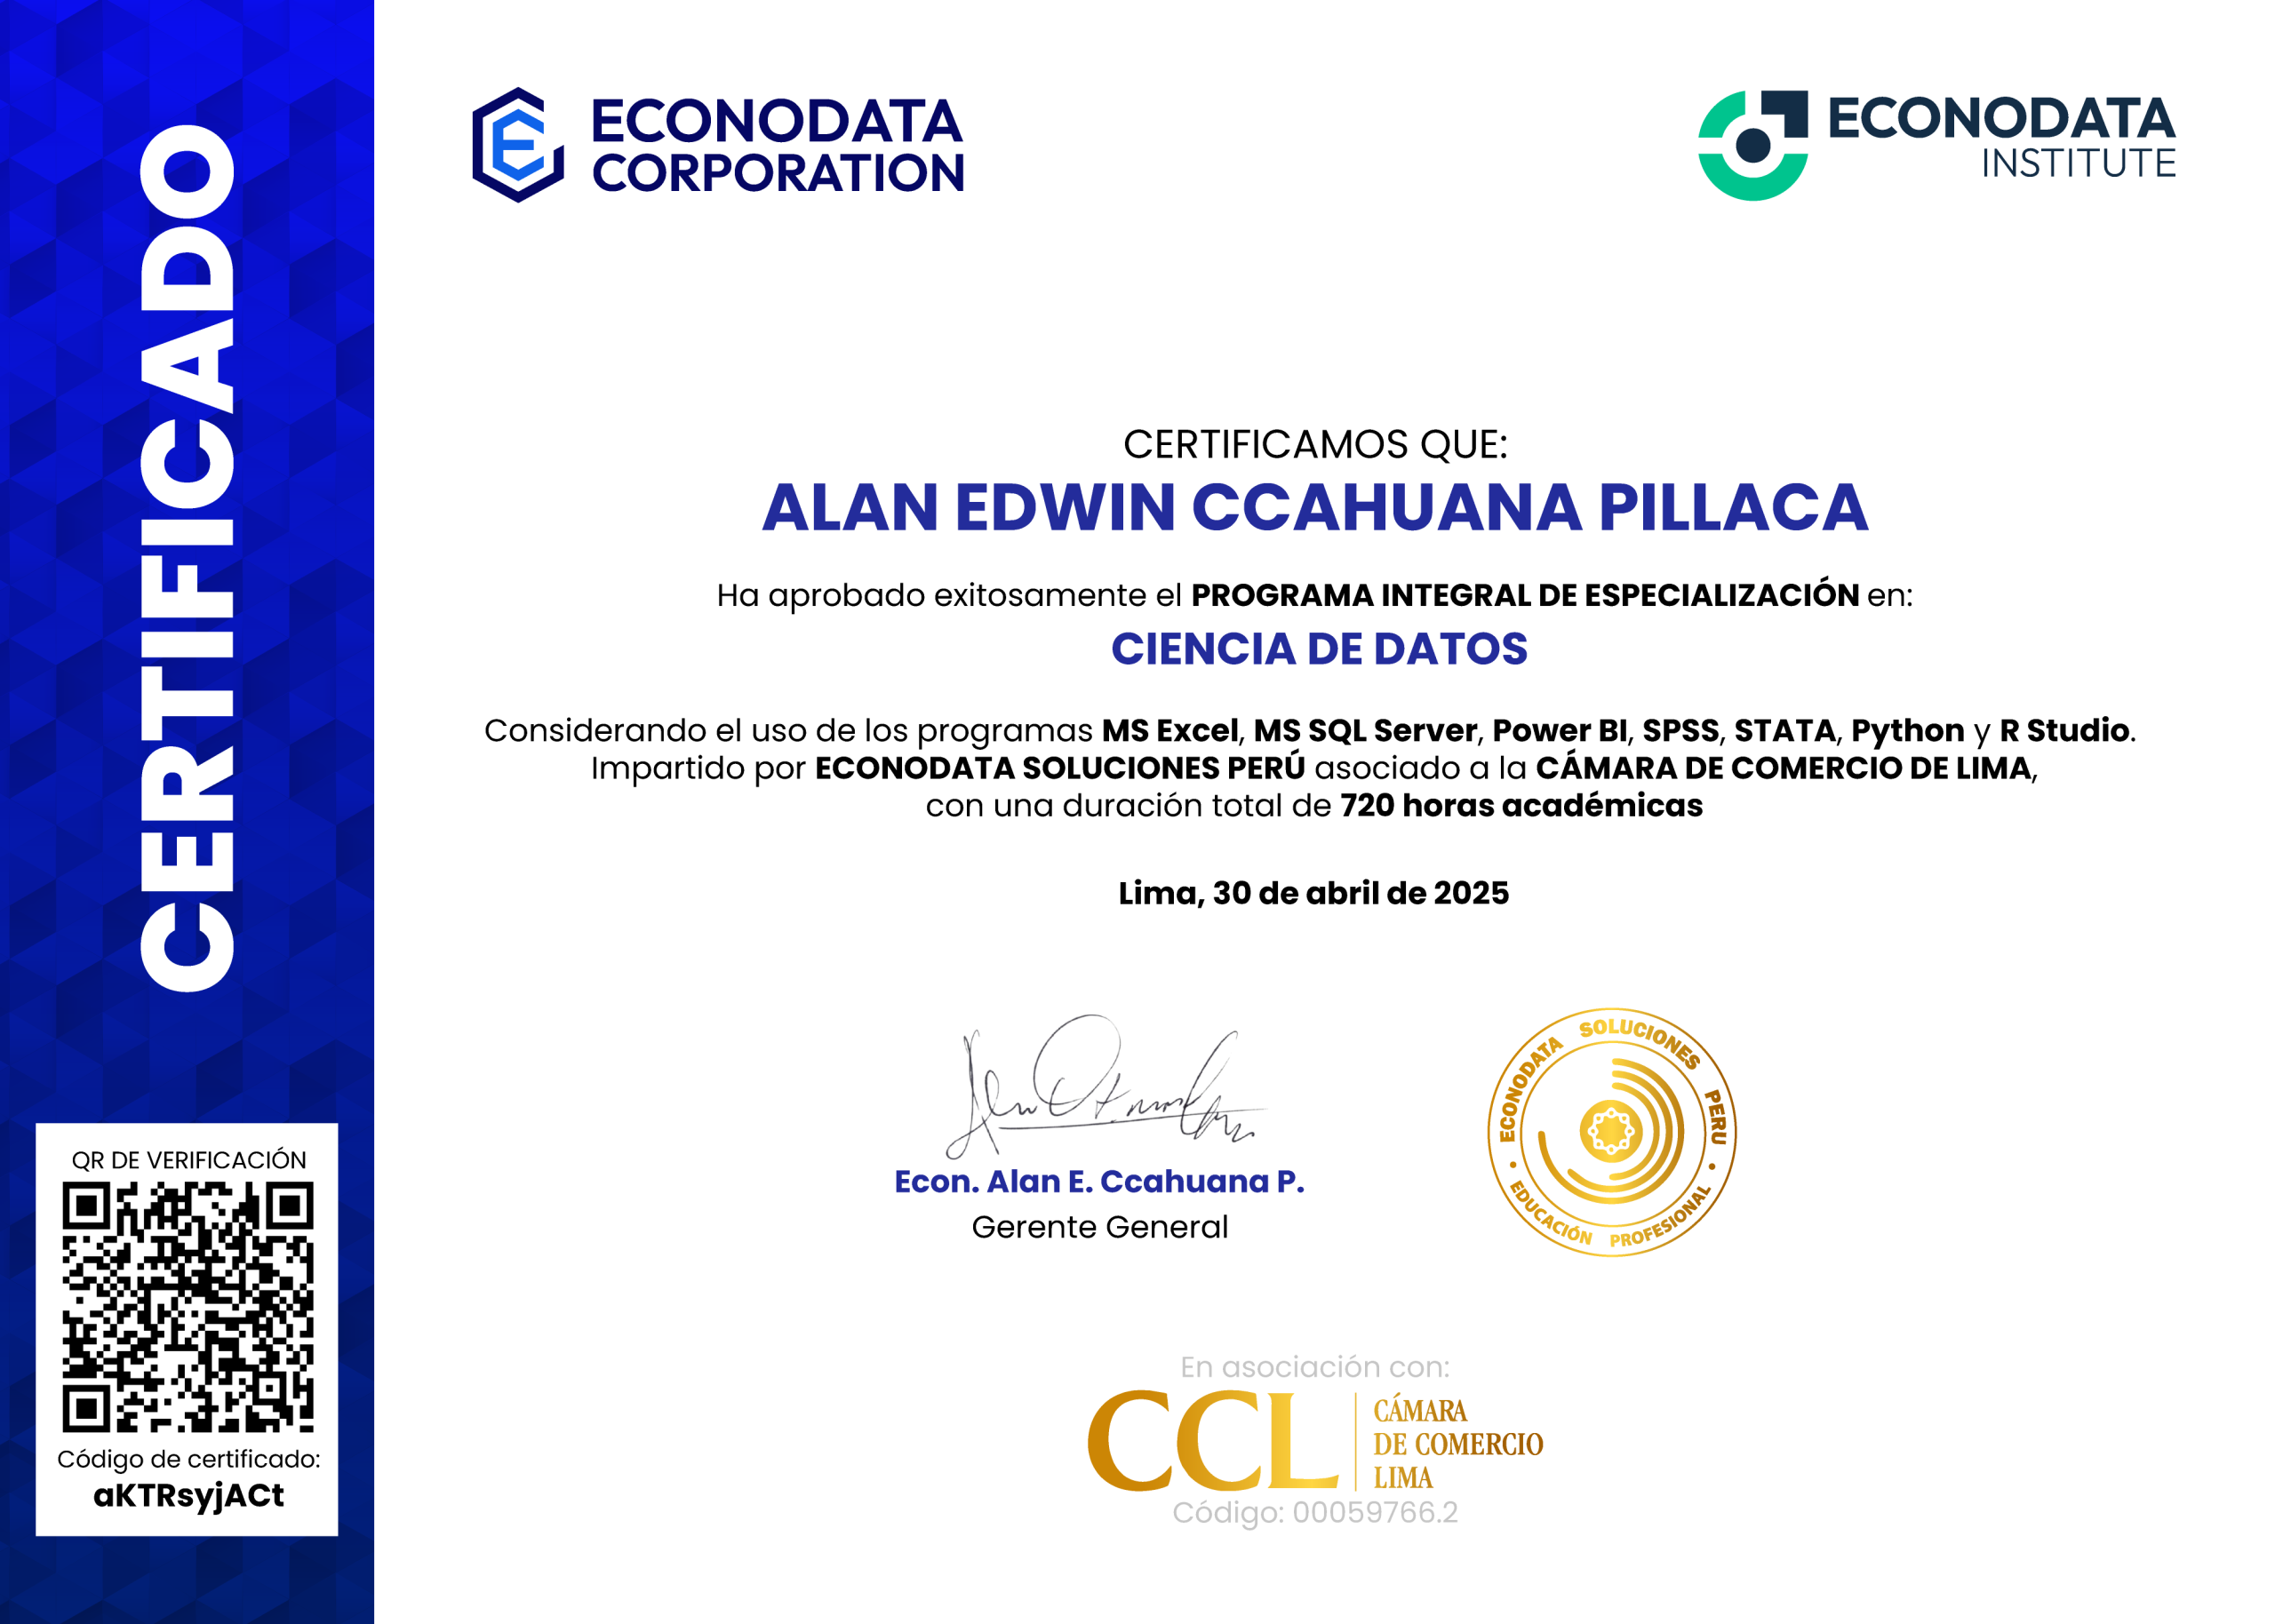
Certificación

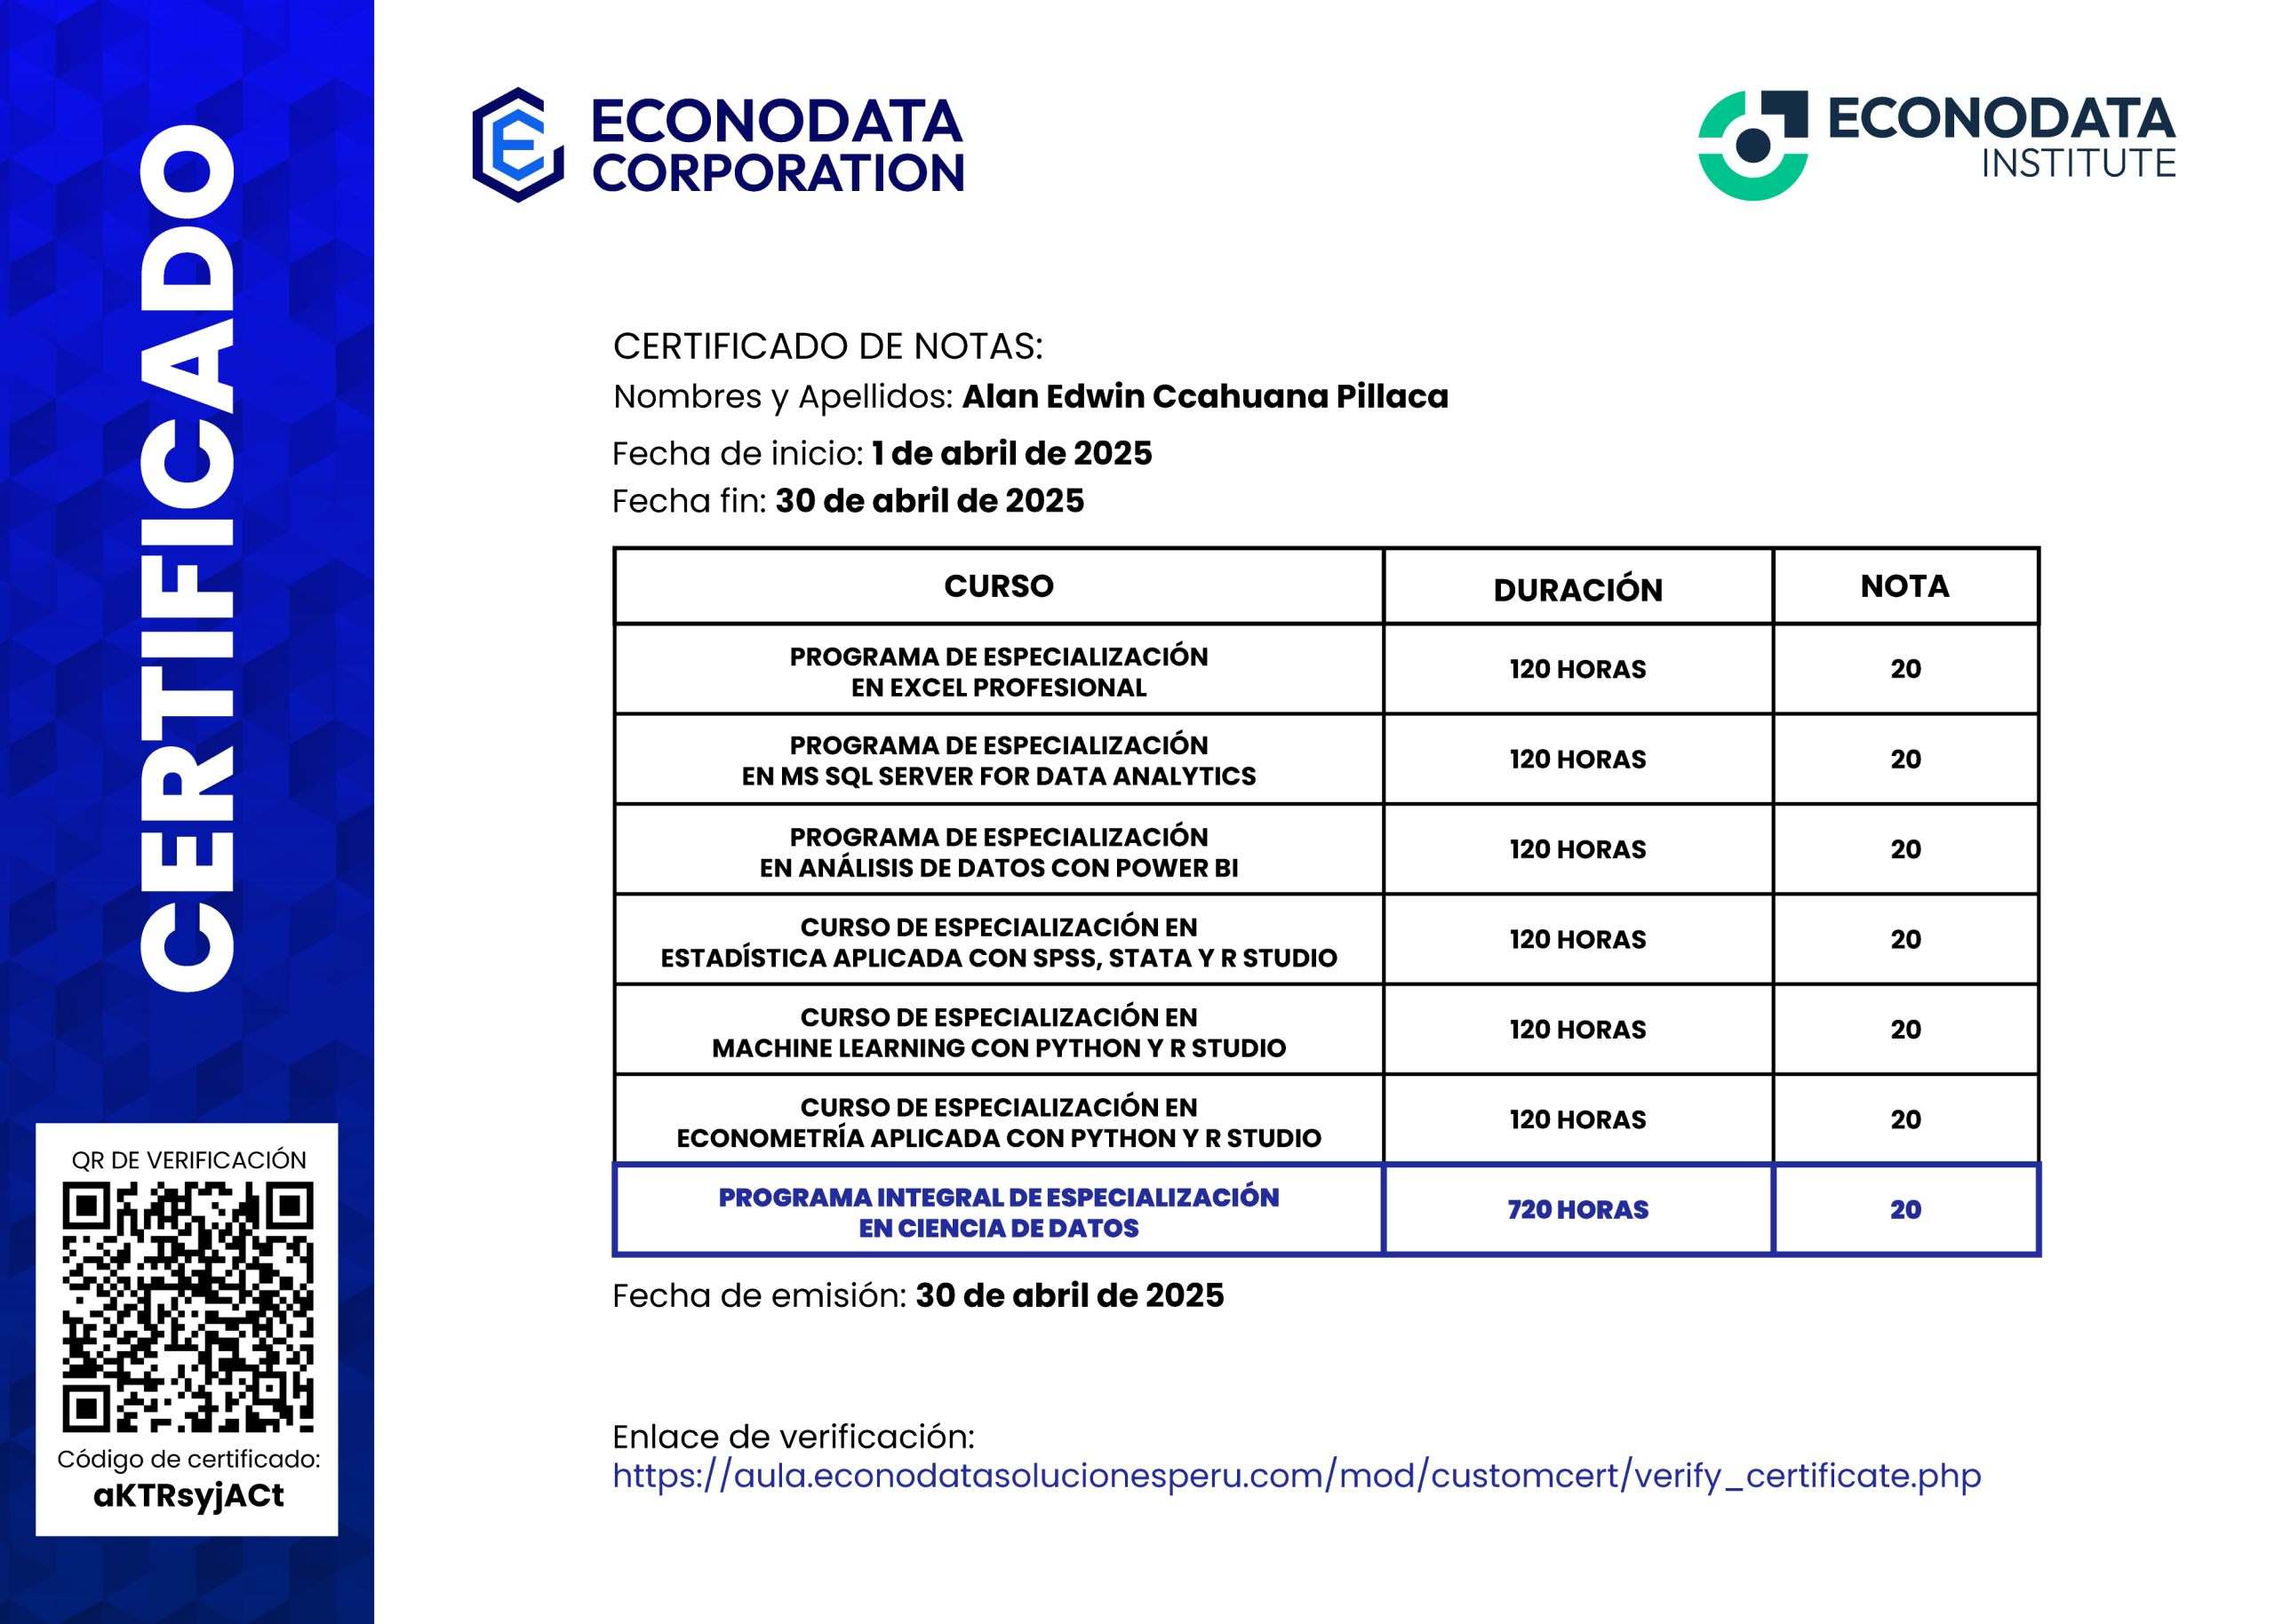
720 Horas Pedagógicas
Requisitos técnicos

🟢MÓDULO I: FUNDAMENTOS DE EXCEL (3 horas)

  1. Introducción al entorno de Excel
  2. Libros, hojas, celdas, rangos
  3. Tipos de datos y formatos básicos
  4. Uso de fórmulas básicas (SUMA, RESTA, PROMEDIO)

🟢MÓDULO II: REFERENCIAS Y FUNCIONES SIMPLES (3 horas)

  1. Referencias relativas, absolutas y mixtas
  2. Relleno automático y series
  3. Funciones condicionales básicas: SI, CONTAR.SI, SUMAR.SI

🟢MÓDULO III: ORGANIZACIÓN Y ANÁLISIS DE DATOS (3 horas)

  1. Ordenar y filtrar
  2. Buscar y reemplazar
  3. Validación de datos sencilla

🟢MÓDULO IV: GRÁFICOS Y PRESENTACIÓN DE RESULTADOS (3 horas)

  1. Tipos de gráficos (columna, línea, circular)
  2. Personalización de gráficos
  3. Inserción de imágenes y formas

🟢MÓDULO V: ORGANIZACIÓN Y ANÁLISIS DE DATOS (3 horas)

  1. Caso integrador: gestión de asistencia con funciones y gráficos
  2. Evaluación prática individual

🟢MÓDULO VI: INTEGRACIÓN DE DATOS Y REFERENCIAS CRUZADAS (3 horas)

  1. Consolidación de datos
  2. Vinculación entre hojas y libros
  3. Validación de datos avanzada (listas desplegables)

🟢MÓDULO VII: FUNCIONES DE BÚSQUEDA (3 horas)

  1. BUSCARV, INDICE, COINCIDIR
  2. Combinación de funciones

🟢MÓDULO VIII: FUNCIONES DE TEXTO Y FECHA (3 horas)

  1. IZQUIERDA, DERECHA, LARGO, EXTRAE, CONCATENAR
  2. HOY, FECHA, DIAS, DIF.DIAS.LAB

🟢MÓDULO IX: TABLAS DINAMICAS Y SEGMENTACIÓN (3 horas)

  1. Creación y personalización de tablas dinámicas
  2. Segmentación de datos
  3. Minigráficos y gráficos combinados

🟢MÓDULO X: TABLAS DINAMICAS Y SEGMENTACIÓN (3 horas)

  1. Caso integrador: análisis de base de datos con gráficos y tablas dinámicas
  2. Evaluación práctica

🟢MÓDULO XI: FUNCIONES ANIDADAS Y EVALUACIÓN LÓGICA (3 horas)

  1. SI anidados
  2. Uso de Y, O, SI.ERROR, ELEGIR
  3. Escenarios

🟢MÓDULO XII: INTRODUCCIÓN A POWER QUERY (3 horas)

  1. Cargar, transformar y limpiar datos
  2. Eliminar duplicados, dividir columnas, transformar tipos

🟢MÓDULO XIII: MODELADO DE DATOS CON POWER PIVOT (3 horas)

  1. Crear relaciones entre tablas
  2. Campos calculados
  3. Introducción de medidas DAX: CALCULATE, FILTER, ALL

🟢MÓDULO XIV: AUTOMATIZACIÓN Y FORMULARIOS (3 horas)

  1. Macros con grabador
  2. Formularios con controles (botones, listas)
  3. Protección y control de formularios

🟢MÓDULO XV: EVALUACIÓN FINAL Y DASHBOARD AVANZADO (3 horas)

  1. Caso integrador: importación, modelado, análisis y visualización
  2. Evaluación práctica integral

🟢MÓDULO XVI: INTRODUCCIÓN A MICROSOFT SQL SERVER 2022 (3 horas)

  1. ¿Qué es Microsoft SQL Server 2022?
  2. ¿Qué es OLTP? ¿Qué es OLAP?
  3. ¿Qué es ETL?
  4. Ediciones de Microsoft SQL Server 2022.
  5. Instalación de SQL Server 2022
  6. Formas de conectarnos a la base de datos de
    SQL Server

🟢MÓDULO XVII: BASE DE DATOS DE MICROSOFT SQL SERVER (3 horas)

  1. ¿Qué es una base de datos?
  2. Tipos de bases de datos
  3. Tipos de objetos de una base de datos
  4. Tipos de consultas
  5. Creación de una base de datos

🟢MÓDULO XVIII: MANTENIMIENTO DE TABLAS (3 horas)

  1. El modelo relacional.
  2. Definición de tabla, Campo y Registro.
  3. Tipos de datos en SQL Server.
  4. Tipos de datos creados por el usuario.
  5. Características de columnas NULL NOT NULL.
  6. Creación de esquemas
  7. Creación de Tablas.
  8. Modificación y eliminación de tablas.
  9. Creación de restricciones de Clave primaria y Clave foránea.
  10. Creación del diagrama de una base de datos relacional en SQL Server.

🟢MÓDULO XIX: MANTENIMIENTO DE DATOS (3 horas)

  1. Inserción de filas
  2. Uso de DEFAULT VALUES
  3. La propiedad IDENTITY
  4. Actualización de datos
  5. Eliminación de datos
  6. Diferencia entre TRUNCATE TABLE y DELETE

🟢MÓDULO XX: MANTENIMIENTO DE DATOS (3 horas)

  1. La instrucción SELECT
  2. Columnas calculadas
  3. Uso de operadores
  4. Estableciendo filtros en la instrucción select
  5. Manipulación de valores NULL
  6. Agrupación y agregación de datos
  7. Caso práctico: Gestión de inventario y actualización de stock
  8. Creación de una tabla a partir de una consulta

🟢MÓDULO XXI: AGRUPAMIENTO Y AGREGACIÓN DE DATOS (3 horas)

  1. Funciones de agregación
  2. Funciones de fecha y hora
  3. Funciones de conversión de datos
  4. Funciones de cadena
  5. Funciones lógicas IF y CASE
  6. La cláusula GROUP BY
  7. El operador PIVOT
  8. Combinaciones o joins
    I. INNER JOIN
    II. LEFT OUTER JOIN
    III. RIGHT OUTER JOIN
    IV. FULL OUTER JOIN
    V. CROSS JOIN

🟢MÓDULO XII: SUBCONSULTAS (3 horas)

  1. Subconsultas definidas en el WHERE
  2. Uso de EXISTS
  3. Clausulas Offset y Fetch
  4. Operadores de conjuntos: UNION, EXCEPT e
    INTERCEPT
  5. Common Table Expression (CTE)
  6. Caso práctico: Evaluación de campañas

🟢MÓDULO XXIII: VISTAS (3 horas)

  1. ¿Qué son las vistas?
  2. Ventajas y desventajas de las vistas
  3. Encriptación de las vistas
  4. Caso práctico: Resumen financiero de cuentas por cobrar

🟢MÓDULO XXIV: GESTIÓN DE ÍNDICES (3 horas)

  1. Concepto
  2. Acceso a los datos
  3. Criterios para crear índices
  4. Creación de índices
  5. Mantenimiento de índices

🟢MÓDULO XXV: FUNDAMENTOS GENERALES (3 horas)

  1. Introducción
  2. Reglas de formato de los identificadores
  3. Las expresiones
  4. Otros elementos del lenguaje

🟢MÓDULO XXVI: ESTRUCTURAS DE CONTROL (3 horas)

  1. Declaración de variables
  2. Estructuras condicionales
  3. Estructuras de bucle
  4. Caso práctico: Verificación de niveles de stock y generación de alertas.

🟢MÓDULO XXVII: PROCEDIMIENTOS ALMACENADOS (3 horas)

  1. Creación y sintaxis de procedimientos almacenados en SQL Server
  2. Parámetros de entrada y salida en procedimientos almacenados
  3. Manejo de excepciones
  4. Optimización de procedimientos almacenados
  5. Caso práctico: Registrar una venta y actualizar el inventario

🟢MÓDULO XXVIII: FUNCIONES (3 horas)

  1. Sintaxis de creación de funciones en SQL Server
  2. Tipos de funciones
    I. Funciones escalares
    II. Funciones con valores de tabla:
    A. Función con valores de tabla insertados
    B. Función con valores de tabla de múltiples instrucciones
  3. Parámetros de entrada en funciones
  4. Uso de variables y estructuras de control en funciones
  5. Consideraciones de rendimiento en la creación de funciones
  6. Ventajas y desventajas de la utilización de funciones en SQL Server
  7. Caso práctico: Cálculo de interés por demora en cuentas por cobrar

🟢MÓDULO XXIX: GESTIÓN DE TRIGGERS (3 horas)

  1. Creación y sintaxis de triggers en SQL Server.
  2. Tipos de triggers: BEFORE e AFTER, INSTEAD OF
  3. Eventos que activan los triggers, como la inserción, actualización o eliminación de datos en una tabla
  4. Acciones que se pueden realizar en respuesta a los eventos, como la ejecución de sentencias SQL o la generación de mensajes de error
  5. Manejo de excepciones y errores en los triggers
  6. Ventajas y desventajas de la utilización de triggers en SQL Server 2022
  7. Caso práctico: Auditoría automática de pagos en cuentas por cobrar

🟢MÓDULO XXX: CURSORES (3 horas)

  1. Sintaxis y tipos de cursores en SQL Server
  2. Apertura, cierre y recorrido de cursores
  3. Uso de cursores para la modificación y eliminación de registros
  4. Uso de cursores para la lectura de datos en tablas
  5. Consideraciones de rendimiento en la utilización de cursores
  6. Ventajas y desventajas del uso de cursores en SQL Server

🟢MÓDULO XXXI: CORREO ELECTRÓNICO EN SQL SERVER (3 horas)

  1. Configuración de perfiles de correo electrónico y servidores SMTP
  2. Uso de procedimientos almacenados y funciones para enviar correos electrónicos
  3. Envío de correo electrónico con consultas SQL Server
  4. Envío de correo electrónico en formato HTML
  5. Envío de correo electrónico con consultas SQL
  6. Server en un archivo adjunto en Microsoft Excel
  7. Caso práctico: Notificar pagos vencidos por correo a supervisores

🟢MÓDULO XXXII: BACKUP Y RESTAURACIÓN DE LA BASE DE DATOS EN SQL SERVER (3 horas)

  1. Conceptos fundamentales de backup en SQL Server
  2. Tipos de backup
  3. Estrategias de backup
  4. Realización de backups completos, diferenciales e incrementales
  5. Programación de backups y mantenimiento de archivos de backup
  6. Restauración de bases de datos a partir de archivos de backup
  7. Monitoreo y administración de backups y restauraciones
  8. Consideraciones de rendimiento y seguridad en la realización de backups
  9. Caso práctico: Respaldo nocturno y restauración de emergencia de la base de datos

🟢MÓDULO XXXIII: SEGURIDAD EN SQL SERVER (3 horas)

  1. Conceptos fundamentales de backup en SQL Server
  2. Tipos de backup
  3. Estrategias de backup
  4. Realización de backups completos, diferenciales e incrementales
  5. Programación de backups y mantenimiento de archivos de backup
  6. Restauración de bases de datos a partir de archivos de backup
  7. Monitoreo y administración de backups y restauraciones
  8. Consideraciones de rendimiento y seguridad en la realización de backups
  9. Caso práctico: Respaldo nocturno y restauración de emergencia de la base de datos

🟢MÓDULO XXXIV: REPORTING SERVICES (SSRS) EN SQL SERVER (3 horas)

  1. Diseño de informes y visualizaciones en SSRS
  2. Uso de tablas, gráficos y matrices en informes de SSRS
  3. Configuración de conexiones y fuentes de datos en SSRS
  4. Creación de informes personalizados en SSRS
  5. Programación y automatización de informes en SSRS
  6. Publicación y distribución de informes en diferentes formatos en SSRS
  7. Caso práctico: Informe de ventas mensuales por región para gerencia

🟢MÓDILO XXXV: FUNDAMENTOS DE POWER BI (3 horas)

  1. Introducción.
  2. Demostración de uso de Power BI.

🟢MÓDULO XXXVI: POWER QUERY (3 horas)

  1. Conexión de datos.
  2. Editor de Power Query.

🟢MÓDULO XXXVII: TRANSFORMACIÓN CON ARCHIVOS LOCALES COMO: MS EXCEL, MS ACCESS, TEXTO (3 horas)

  1. Transformaciones de datos.
  2. Transformaciones de columnas.
  3. Manejo de errores.

🟢MÓDULO XXXVIII: TRANSFORMACIÓN CON ARCHIVOS EN LA NUBE DE ONEDRIVE (3 horas)

  1. Transformación de datos One Drive – Sharepoint.

🟢MÓDULO XXXIX: MODELAMIENTO DE DATOS BÁSICOS (3 horas)

  1. Relaciones de tablas.
  2. Conexión dinámica con base de datos relacionales en SQL Server.

🟢MÓDULO XL: VISUALIZACIÓN DE DATOS (3 horas)

  1. Visualización de objetos visuales.

🟢MÓDULO XLI: FUNCIONES AVANZADAS EN POWER QUERY (3 horas)

  1. Tablas Anexadas y Combinadas.
  2. Funciones con lenguaje M.

🟢MÓDULO XLII: MODELADO DE DATOS (3 horas)

  1. Introducción a las bases de datos.
  2. Estructuras del modelado de bases de datos.

🟢MÓDULO XLIII: FUNCIONES DAX DE COLUMNA (3 horas)

  1. Funciones DAX para columna.
  2. Agrupación de datos.

🟢MÓDULO XLIV: VISUALIZACIÓN DE DATOS Y DISEÑO DE TABLEROS DE MANDO (3 horas)

  1. Objetos visuales.
  2. Diseño de tableros de mando con principios de UX.
  3. Desarrollo de tableros de mando.

🟢MÓDULO XLV: HERRAMIENTAS DE ANÁLISIS DE DATOS (3 horas)

  1. Herramientas de administración visual de los objetos visuales.
  2. Resumen y distribución.
  3. Panel de Análisis.

🟢MÓDULO XLVI: MEDIDAS DAX (3 horas)

  1. Totalizaciones con filtros.

🟢MÓDULO XLVII: BOTONES PROGRAMADOS CON DAX (3 horas)

  1. Obtención de detalles.
  2. Navegación de Páginas.
  3. Marcadores.

🟢MÓDULO XLVIII: EJES DINÁMICOS CON FUNCIONES DAX (3 horas)

  1. Tablas con NAMEOF.
  2. Segmentación Avanzada.
  3. Funciones DAX para Obtención de datos seleccionados.

🟢MÓDULO XLIX: FUNCIONES DAX MÁS UTILIZADAS (3 horas)

  1. Funciones X.
  2. Filtros y Totalizaciones con tablas.
  3. Funciones de Inteligencia de Tiempo.

🟢MÓDULO L: HIPÓTESIS CON DAX (3 horas)

  1. Generación de tablas con GENERATESERIES.
  2. Casos Práctico.

🟢MÓDULO LI: RESUMEN DE DATOS CON TABLAS AUTOGENERADAS (3 horas)

  1. Uso de la función SUMMARIZE.
  2. Uso de la función GROUP BY.
  3. Uso de la función UNION.
  4. Uso de la función NATURALINNERJOIN.

🟢MÓDULO LII: DAX STUDIO (3 horas)

  1. Instalado de DAX Studio.
  2. Conexión Power BI – DAX Studio.
  3. Editor de DAX Studio.

🟢MÓDULO LIII: INTRODUCCIÓN A R STUDIO Y SPSS (3 horas)

  1. Instalación de SPSS, Stata y R Studio
  2. Arquitectura e interfaz de SPSS, Stata y R Studio

🟢MÓDULO LIV: INTRODUCCIÓN A SPSS, STATA Y CONCEPTOS BÁSICOS DE ESTADÍSTICA (3 horas)

  1. Instalación del software SPSS y Stata.
  2. Conceptos fundamentales de estadística:
    Definición de estadística, población y muestra.
    Variables: tipos, escalas de medición y niveles de medición.
  3. Gráficos según el tipo de variable.
  4. Organización de datos: Tablas de distribución de frecuencia para variables cuantitativas discretas y categóricas.

🟢MÓDULO LV: DISTRIBUCIONES DE PROBABILIDAD (3 horas)

  1. Tablas de distribución de frecuencia para variables cuantitativas continuas.
  2. Medidas de tendencia central:
    Promedio, mediana y moda.
    Relación entre promedio, mediana y moda.
  3. Cuartiles, deciles y percentiles.
  4. Medidas de dispersión.
  5. Aplicaciones prácticas en R, SPSS y Stata.

🟢MÓDULO LVI: ANÁLISIS GRÁFICO Y APLICACIONES ESTADÍSTICAS (3 horas)

  1. Continuación de aplicaciones con R.
  2. Representación gráfica de datos:
    Creación de gráficos.
    Análisis con gráficos de cajas.
  3. Aplicaciones prácticas en R, SPSS y Stata.

🟢MÓDULO LVII: INTRODUCCIÓN A LAS PROBABILIDADES (3 horas)

  1. Conceptos básicos de probabilidad:
    Experimentos aleatorios, espacio muestral y eventos.
    Definiciones clásicas, frecuentistas y axiomáticas de probabilidad.
    Propiedades de la probabilidad.
  2. Probabilidad condicional e independencia de eventos.
  3. Regla de la multiplicación y regla de la adición.
  4. Teorema de Bayes.

🟢MÓDULO LVIII: VARIABLES ALEATORIAS Y DISTRIBUCIONES (3 horas)

  1. Conceptos básicos de variables aleatorias:
    Función de distribución de una variable aleatoria.
    Función de densidad de probabilidad.
  2. Variables aleatorias discretas:
    Distribución binomial.
  3. Distribuciones muestrales.
  4. Comandos en R y Stata para trabajar con distribuciones:
    Distribuciones más conocidas en R y Stata.

🟢MÓDULO LIX: ESTADÍSTICA INFERENCIAL (3 horas)

  1. Conceptos básicos de inferencia estadística.
  2. Estimación puntual.
  3. Estimación por intervalos.
  4. Pruebas de hipótesis:
    Para la media, proporción y varianza.
    Para diferencias de medias.
  5. Análisis y comparación de dos muestras independientes mediante la prueba t.
  6. Aplicaciones prácticas en R, SPSS y Stata.

🟢MÓDULO LX: APLICACIONES INTEGRALES Y ANÁLISIS AVANZADO (3 horas)

  1. Aplicación práctica de todos los conceptos y herramientas vistas en sesiones anteriores.
  2. Análisis exhaustivo de datos utilizando R, SPSS y Stata.
  3. Pruebas de normalidad y su interpretación.
  4. Uso integrado de las herramientas para la solución de problemas estadístico

🟢MÓDULO LXI: EXAMEN PARCIAL Y RESOLUCIÓN (3 horas)

  1. Examen (1.5 horas)
  2. Resolución (1.5 horas)

🟢MÓDULO LXII: REGRESIÓN LINEAL (3 horas)

  1. Modelo de regresión lineal simple: Coeficientes, R², aplicación y predicción
  2. Programas: Implementación y análisis de regresión lineal en SPSS, Stata y R Studio; ajuste del modelo y evaluación de supuestos.

🟢MÓDULO LXIII: ANÁLISIS DE VARIANZA (ANOVA) (3 horas)

  1. Concepto y aplicación de ANOVA: Comparación de medias de múltiples grupos, supuestos de normalidad y homogeneidad de varianzas
  2. Programas: Realización y análisis de ANOVA en SPSS, Stata y R Studio; interpretación de resultados y post-hoc tests.

🟢MÓDULO LXIV: INTRODUCCIÓN AL ANÁLISIS MULTIVARIADO Y REGRESIÓN MÚLTIPLE (3 horas)

  1. Conceptos básicos y técnicas comunes: Regresión múltiple
  2. Programas: Implementación de análisis multivariado y regresión múltiple en SPSS, Stata y R Studio; análisis de modelos con múltiples variables independientes.

🟢MÓDULO LXV: ANÁLISIS DE COMPONENTES PRINCIPALES (ACP) (3 horas)

  1. Fundamentos del ACP: Reducción de dimensionalidad, interpretación de componentes
  2. Programas: Realización del ACP en SPSS, Stata y R Studio; visualización de componentes y selección de variables.

🟢MÓDULO LXVI: REFORZAMIENTO CON R Y STATA ANÁLISIS DE COMPONENTES PRINCIPALES ACP (3 horas)

  1. Fundamentos del ACP: Reducción de dimensionalidad, interpretación de componentes
  2. Programas: Realización del ACP en SPSS, Stata y R Studio; visualización de componentes y selección de variables.

🟢MÓDULO LXVII: REGRESIÓN LOGÍSTICA (LOGIT) (3 horas)

  1. Regresión logística binaria: Modelado, interpretación de coeficientes, evaluación del modelo
  2. Programas: Implementación y evaluación de modelos logísticos en SPSS, Stata y R Studio; análisis de curvas ROC y métricas de rendimiento.

🟢MÓDULO LXVIII: ANÁLISIS CLUSTER (3 horas)

  1. Análisis de clusters: Métodos jerárquicos (dendrogramas) y no jerárquicos (k-means), aplicaciones en segmentación de datos.
  2. Programas: Realización de análisis de agrupamientos en SPSS, Stata y R Studio; visualización de clusters y evaluación de resultados.

🟢MÓDULO LXIX: EXAMEN FINAL Y RESOLUCIÓN (3 horas)

  1. Examen (2 horas)
  2. Resolución (2 horas)

🟢MÓDULO LXX: INTRODUCCIÓN A LA ECONOMETRÍA Y FUNDAMENTOS ESTADÍSTICOS (3 horas)

  1. Conceptos básicos de econometría: corte transversal, series de tiempo, datos de panel
  2. Estadística y probabilidades aplicadas: conceptos de inferencia, distribuciones y pruebas de hipótesis.
  3. Introducción a Python y R para econometría: estructuras de datos, paquetes relevantes (statsmodels, scipy, pandas en Python; lm, tidyverse, forecast en R).
  4. Caso práctico: Analizar la relación entre la edad y el salario utilizando un dataset real.
  5. Objetivo: Aplicar conceptos básicos de estadística descriptiva y realizar una prueba de hipótesis sobre la media de los salarios.
  6. Datos sugeridos: Dataset ENAHO.

🟢MÓDULO LXXI: ANÁLISIS DE REGRESIÓN LINEAL SIMPLE Y MÚLTIPLE (3 horas)

  1. Modelo de regresión lineal: estimación por MCO, supuestos básicos, interpretación de resultados.
  2. Implementación en Python y R: ajuste de modelos y análisis de residuos.
  3. Diagnóstico del modelo: multicolinealidad, heterocedasticidad, autocorrelación. Teoría y práctica.
  4. Técnicas de transformación de variables y análisis de colinealidad.
  5. Objetivo: Interpretar los coeficientes y verificar los supuestos del modelo (linealidad, homocedasticidad, no autocorrelación).
  6. Datos sugeridos: Dataset con salario, años de experiencia, nivel educativo.

🟢MÓDULO LXXII: REGRESIÓN CON VARIABLES CATEGÓRICAS Y VARIABLES INSTRUMENTALES (3 horas)

  1. Uso de variables dummy y efectos de interacción.
  2. Introducción a las variables instrumentales: identificación, problemas de endogeneidad, instrumentos válidos.
  3. Ejemplo aplicado en Python y R.
  4. Caso práctico: Evaluar el impacto de tener un título universitario sobre el salario.
  5. Objetivo: Mostrar el uso de variables dummy y discutir endogeneidad.
  6. Datos sugeridos: Variables salario, título universitario (dummy), distancia a la universidad.

🟢MÓDULO LXXIII: MODELOS PARA DATOS DE CORTE TRANSVERSAL NO LINEALES (3 horas)

  1. Modelos logit y probit para variables dependientes binarias.
  2. Modelos multinomiales y ordenados.
  3. Interpretación y cálculo de efectos marginales en Python y R.
  4. Caso práctico: Modelar la probabilidad de que una persona tenga acceso a un seguro de salud basado en su ingreso y educación.
  5. Objetivo: Ajustar modelos logit/probit y calcular efectos marginales.
  6. Datos sugeridos: Dataset con seguro de salud (dummy), ingreso, nivel educativo.

🟢MÓDULO LXXIV: ANÁLISIS DE SERIES DE TIEMPO UNIVARIADAS (3 horas)

  1. Conceptos básicos: estacionariedad, diferencia, autocorrelación.
  2. Modelos ARIMA: identicación, estimación y diagnóstico.
  3. Introducción a la predicción y el análisis de errores de pronóstico.
  4. Aplicación de modelos ARIMA en Python (statsmodels) y R (forecast).
  5. Caso práctico: Predecir el valor futuro de una serie de precios mensuales de un producto (precio del petróleo, oro, acciones Apple).
  6. Objetivo: Identicar un modelo ARIMA adecuado y evaluar su capacidad predictiva.
  7. Datos sugeridos: Serie de tiempo de precios mensuales (google FInance, Yahoo finance etc.)

🟢MÓDULO LXXV: MODELOS DE SERIES DE TIEMPO MULTIVARIADAS Y CAUSALIDAD (3 horas)

  1. Modelos VAR y VECM: especificación, estimación y causalidad de Granger.
  2. Cointegración y pruebas de raíz unitaria (ADF, Phillips-Perron).
  3. Ejercicios prácticos en Python y R, incluyendo visualización de resultados.
  4. Caso práctico: Analizar la relación entre la tasa de desempleo y la inflación utilizando un modelo VAR.
  5. Objetivo: Evaluar causalidad de Granger y explorar la cointegración.
  6. Datos sugeridos: Series temporales de desempleo e inflación en el Perú.

🟢MÓDULO LXXVI: MODELOS DE DATOS DE PANEL (3 horas)

  1. Introducción a los datos de panel: estructura, ventajas y desafíos.
  2. Modelos de efectos jos y aleatorios: estimación e interpretación.
  3. Pruebas de Hausman y de elección de modelo.
  4. Implementación en Python y R, usando paquetes como plm en R y linearmodels en Python.
  5. Caso práctico: Estudiar el impacto de políticas gubernamentales en el desempleo usando datos de panel de diferentes regiones.
  6. Objetivo: Implementar modelos de efectos fijos y aleatorios y realizar la prueba de Hausman.
  7. Datos sugeridos: Datos de panel con región, año, desempleo, gasto público. Datos de 4 países del Mercosur en 5 años.

🟢MÓDULO LXXVII: MACHINE LEARNING EN ECONOMETRÍA (3 horas)

  1. Introducción al aprendizaje automático: regresión regularizada (Lasso y Ridge), árboles de decisión, y bosques aleatorios.
  2. Aplicaciones a problemas económicos y financieros.
  3. Ejemplos prácticos de regresión regularizada en Python y R, y breve introducción a paquetes de ML (sklearn en Python).
  4. Caso práctico: Predecir los ingresos de individuos utilizando regresión Lasso y Ridge para manejar multicolinealidad.
  5. Objetivo: Comparar el rendimiento predictivo de Lasso y Ridge.
  6. Datos sugeridos: Dataset con múltiples predictores económicos.

🟢MÓDULO LXXVIII: PROYECTO INTEGRAL FINAL E INTERPRETACIÓN DE RESULTADOS (3 horas)

  1. Desarrollo de un proyecto aplicando técnicas de corte transversal, series de tiempo, o
    panel.
  2. Interpretación, presentación de resultados, y discusión de implicaciones económicas.
  3. Consejos para documentar y comunicar análisis econométricos de manera efectiva
  4. Dashboard y reportes.
  5. Caso práctico: Los estudiantes desarrollan un proyecto desde cero, eligiendo uno de los métodos aprendidos.
  6. Objetivo: Demostrar la capacidad de integrar, analizar y comunicar resultados econométricos.
  7. Datos sugeridos: Cada estudiante/grupo elige un dataset según sus intereses.

🟢MÓDULO LXXIX: FUNDAMENTOS DE PYTHON Y R STUDIO (3 horas)

  1. Introducción a Python y R Studio.
  2. Manipulación de datos con Pandas.

🟢MÓDULO LXXX: PRE TRATAMIENTO DE BASES DE DATOS (3 horas)

  1. Operaciones matemáticas y álgebra lineal
  2. Gráficas y visualizaciones básicas con Matplotlib y Seaborn.

🟢MÓDULO LXXXI: BALANCEO DE BASE DE DATOS 1 (3 horas)

  1. Identificación y tratamiento de valores
  2. Transformación de variables categóricas (One-Hot Encoding y Label Encoding).

🟢MÓDULO LXXXII: BALANCEO DE BASE DE DATOS 2 (3 horas)

  1. Balanceo de datos desbalanceados.
  2. Normalización y estandarización de datos.

🟢MÓDULO LXXXIII: ANÁLISIS DE COMPONENTES PRINCIPALES (ACP) (3 horas)

  1. Introducción al aprendizaje no supervisado.
  2. Reducción de dimensionalidad: Análisis de Componentes Principales (ACP/PCA).

🟢MÓDULO LXXXIV: ACP Y MODELOS DE CLUSTERING (3 horas)

  1. Modelos de clustering: K-Means y DBSCAN.
  2. Interpretación y visualización de resultados.

🟢MÓDULO LXXXV: REGRESIÓN LINEAL (3 horas)

  1. Introducción a la regresión lineal.
  2. Modelo de Regresión lineal.
  3. Evaluación del modelo.

🟢MÓDULO LXXXVI: REGRESIÓN LINEAL MÚLTIPLE (3 horas)

  1. Regresión múltiple y selección de variables.
  2. Evaluación del modelo: MSE, RMSE y R-cuadrado.

🟢MÓDULO LXXXVII: REGRESIÓN LOGÍSTICA (3 horas)

  1. Concepto de regresión logística.
  2. Diferencias con la regresión lineal.
  3. Curva ROC y métricas de clasificación: Accuracy, Precision, Recall y F1-Score.

🟢MÓDULO LXXXVIII: ANÁLISIS DISCRIMINANTES LINEAL Y ANÁLISIS (3 horas) FACTORIAL

  1. Análisis Discriminante Lineal (LDA): Uso en problemas de clasificación.
  2. Análisis Factorial: Diferencias con PCA y interpretación de factores.

🟢MÓDULO LXXXIX: ARBOLES DE DECISIÓN / RANDOM FOREST (3 horas)

  1. Construcción de un árbol de decisión.
  2. Importancia de las variables.
  3. Random Forest: Concepto de ensambles (bagging) / Ventajas y desventajas.

🟢MÓDULO XC: REDES NEURONALES (3 horas)

  1. Conceptos básicos: Neuronas, pesos, bias y Funciones de activación (ReLU, Sigmoid, Tanh).
  2. Arquitectura de una red neuronal: Capas de entrada, ocultas y de salida.
  3. Forward Propagation y Backward Propagation.
  4. Función de costo y optimización (SGD, Adam).
  5. Ajuste de hiperparámetros (tasa de aprendizaje, épocas, batch size).


Precio del Curso

S/499.00

*PRONTO PAGO VÁLIDO HASTA EL 28 DE MARZO*
Docente
CIENCIA DE DATOS